Sampling hard circuits with verifiably high fidelity
1. 왜 이 논문에 주목해야 하나?
그동안의 양자우위 실험은 2가지 딜레마가 있었다.
1) 어렵게 만들면 오류가 많다
고전 컴퓨터가 못 푸는 Random Circuit Sampling(RCS)을 쓰면 깊이가 깊어질수록 오류가 쌓인다.
2) 검증하려면 고전 시뮬레이션이 필요하다
결과가 맞는지 확인하려면 고전 컴퓨터로 다시 계산해야 하는데, 그러면 “고전이 못 푸는 문제”라는 전제 자체가 무너지고 만다.
IBM과 시카고 대학 팀은 이걸 한 방에 해결!!
2. 핵심 아이디어: Doped Clifford Sampling (DCS)
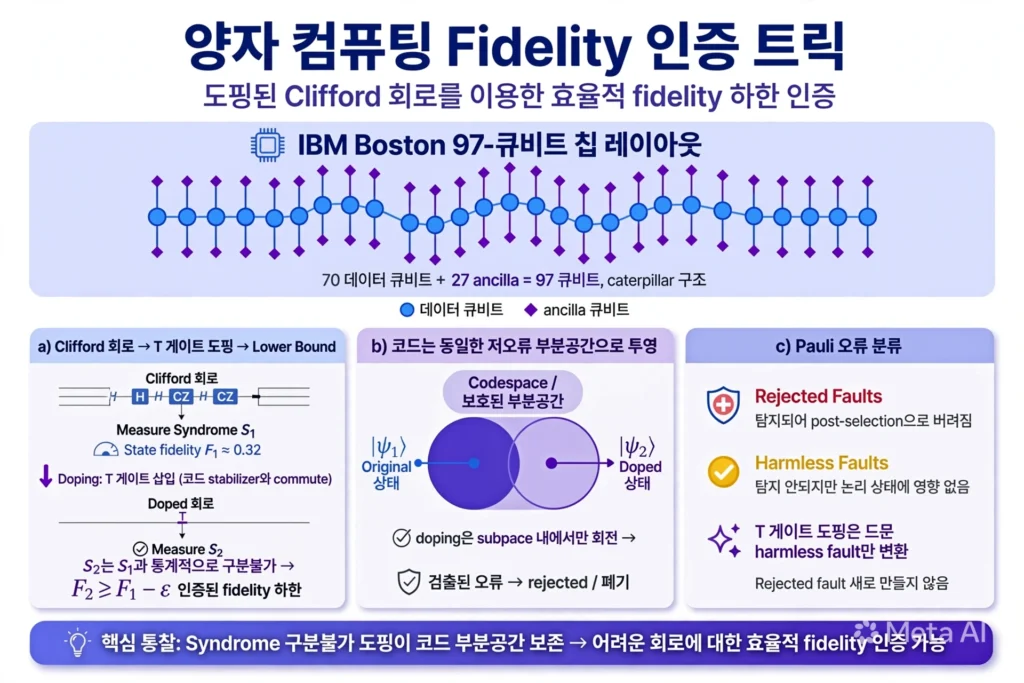
그림의 트릭을 한 문장으로 요약하면 “측정 가능한 친구(Clifford)로 검증하고, 측정 불가능한 본체(Doped 회로)는 친구와 똑같이 행동하게 만든다” 이다.
a) Clifford → T 도핑으로 경도 만들기
위쪽 Clifford 회로는 고전 시뮬레이션이 가능해서 fidelity F1을 DFE로 직접 잴 수 있고, syndrome S1도 효율적으로 측정된다. 여기에 T 게이트를 넣는데, 코드 stabilizer와 교환(commute)되는 자리에만 넣는다. 그러면 아래 Doped 회로의 syndrome S2 분포가 S1과 통계적으로 구분 불가능해진다. 그래서 F1을 알면 F2의 하한인 F2 ≥ F1 – ε 를 자동으로 얻는다.
b) 같은 저오류 부분공간에 가두기
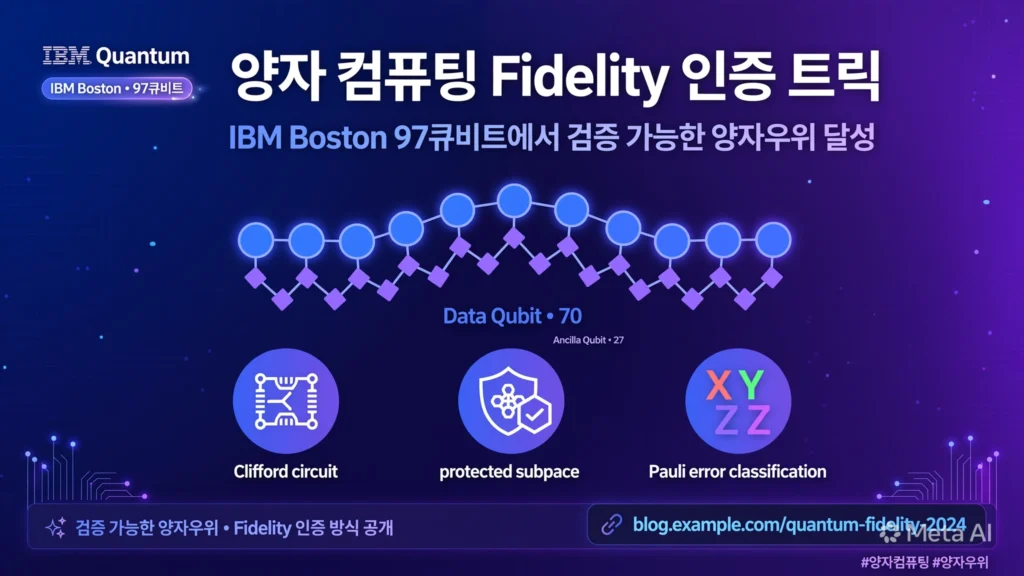
오류정정 코드가 두 상태를 같은 보호된 부분공간(low-error subspace)으로 projection 한다. 도핑은 이 부분공간을 벗어나지 않고 안에서만 회전(rotation)시키는데 바깥(Error Subspace)으로 나가는 오류는 탐지되어 버려지고, 안에 남는 오류만 남으니 검증이 유지된다.
c) Pauli Fault 분류가 핵심 – 모든 오류를 두 종류로 분류함.
- Rejected Faults: syndrome에 걸려서 post-selection으로 버려짐
- Harmless Faults: 탐지 안 되지만 논리 상태에도 영향 안 줌
T 도핑은 Rejected Fault를 새로 만들지 않는다. 단지 드문 Harmless Fault를 다른 Harmless Fault로 바꿀 뿐이다. 랜덤 Clifford에서는 Harmless Fault 확률 자체가 점근적으로 무시할 수준이라, fidelity 손실은 최대 0.013(1)에 불과. 그래서 syndrome 통계가 안 바뀌고, F2 하한이 성립하게 된다.
이게 바로 XEB처럼 “노이즈가 약하고 균일하다”는 강한 가정이 필요 없는 이유다. IBM은 이 트릭으로 70큐비트, T게이트 468개짜리 고전적으로 불가능한 회로에서 fidelity 0.284를 인증했다.
아이디어는 정말 영리한데 좀 더 기술적으로 설명하면 이렇다.
Step 1. 검증 가능한 회로부터 시작
Clifford 회로는 고전적으로 시뮬레이션이 가능해서 fidelity를 직접 측정할 수 있다. Direct Fidelity Estimation(DFE)이라는 방법으로 80개 stabilizer만 측정하면 끝난다.
Step 2. Spacetime Code로 감싸기
여기에 spacetime code를 입힌다. 70개 데이터 큐비트 + 27개 ancilla = 총 97큐비트. Ancilla가 오류를 탐지하고, 오류가 있으면 버린다(post-selection). 논문에선 1차 오류의 92%를 탐지했고, fidelity가 29배나 올랐다고 설명한다.
Step 3. 마법을 살짝 뿌리기 – T 게이트 도핑
이제 고전적으로 어렵게 만들어야 하는 작업이 남아있다. Clifford만으로는 고전이 쉽게 시뮬레이션하기 때문에 T 게이트(=마법)를 468개 넣는다.
여기서 포인트: T 게이트는 코드의 stabilizer와 commute(교환)되는 위치에만 넣는다. 그래서 syndrome 분포가 도핑 전후가 거의 동일하다. IBM 하드웨어에서 T는 가상 Z 회전이라 추가 노이즈도 없다.
결과적으로?
Clifford 상태 fidelity 0.32를 측정하면, 고전적으로 시뮬레이션 불가능한 T-도핑 상태의 fidelity 하한을 0.284 (95% 신뢰도)로 자동 보장할 수 있다.
3. 실험 결과 – 숫자로 보기
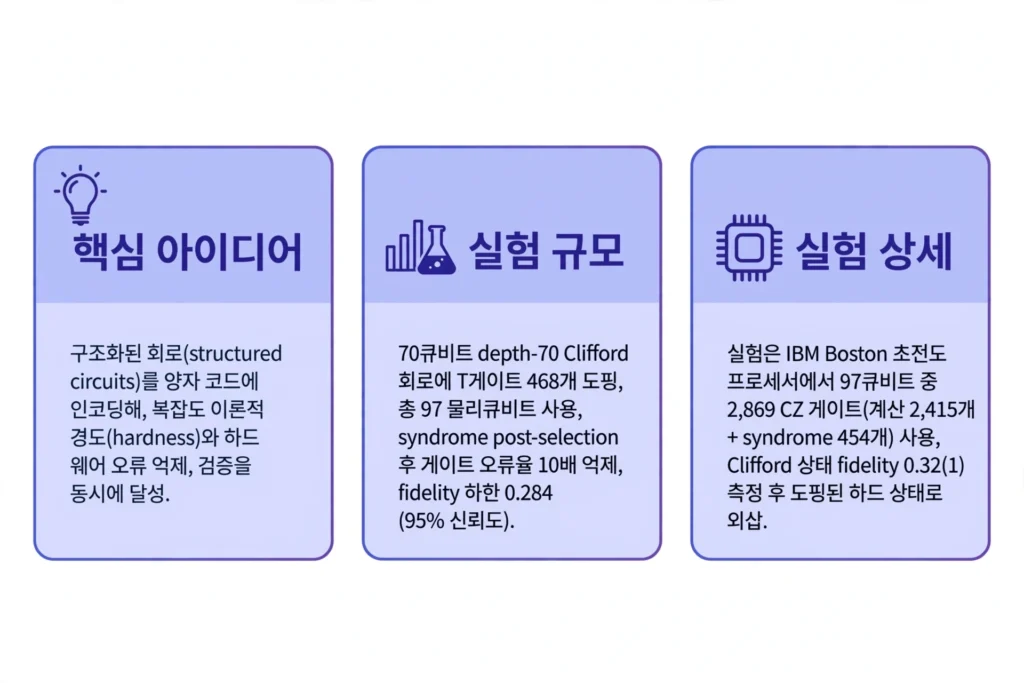
- 회로: 70큐비트, depth 70, CZ게이트 2,415개 + syndrome 측정 454개
- 샘플: 16.1분 동안 2,051개 post-selected 샘플 수집
- 성능: Syndrome post-selection으로 게이트 오류율 10배 억제, post-selection rate는 5.9 x 10^-4
- 검증: XEB처럼 “노이즈가 균일하고 약하다”는 강한 가정이 필요 없음. 일반 Pauli 노이즈 모델만 가정
그리고 이 정도 규모의 샘플링은 현재 tensor-network나 stabilizer 기반 고전 알고리즘으로 사실상 불가능하다고 논문은 추정함.
4. 양자컴퓨팅 미래에 던지는 시사점
이 논문은 양자컴퓨팅의 패러다임 전환을 선언하고 있다.
“더 많은 큐비트 경쟁 → 더 믿을 수 있는 논리 큐비트 경쟁”
Google Willow가 13,000배 빠른 “Quantum Echoes”로 검증 가능성을 외쳤다면, IBM은 70 논리큐비트에서 “오류 탐지와 경도 증명을 동시에 만족하는 체계적인 방법”을 제시했다. Jay Gambetta가 “We are now firmly in the quantum advantage era”라고 말한 이유다.
앞으로의 관전 포인트는 3가지:
- QΨ 이론(단일 큐비트로 10^7배 이득)처럼 이 spacetime 코드가 실제 화학·금융 문제로 확장될 수 있을까?
- post-selection 오버헤드 860배를 어떻게 줄일까?
- 이 인증 방식이 2029년 IBM Starling(200논리큐비트) 로드맵에 어떻게 녹아들까?
논문 정보
- 제목: Sampling hard circuits with verifiably high fidelity
- 저자: Simon Martiel, Jay-U Chung, Alireza Seif, Soumik Ghosh, Ian Hincks, Abhinav Deshpande, Bill Fefferman, Jay M. Gambetta, Ali Javadi-Abhari (IBM Research + UChicago)
- arXiv Abstract 페이지: https://arxiv.org/abs/2607.25941v1